TSTiles, des tuiles TimeSeries pour l'affichage de données météo
Chez Sereno, Weather View est l’application qui affiche des données météo sur une carte interactive en 3D.
En 5 ans, le système d’affichage de ces données a connu 3 version majeures, qui répondaient chacune aux besoins du moment. La dernière version de l’application utilise maintenant ce que nous appelons les TSTiles, des tuiles basées sur Parquet & Arrow qui nous apportent de nombreux avantages.
Cet article est assez long car il retrace l’évolution des besoins et des solutions mises en oeuvre. Pour aller directement à l’implémentation des TSTiles, c’est ici
Les débuts de Weather View
En 2021, je rejoignais HD Rain, devenu Sereno, pour une aventure passionnante qui allait durer 5 ans. Je n’imaginais pas que je serais amené à travailler sur tant de choses: front, back, data, infra, SIG (Systèmes d’Information Géographique).
Le fil rouge : Weather View, une web map React + deck.gl qui permet d’afficher des données météo.

La première version de cette application (Weather View v0) posait déjà les principes qui structurent encore l’application aujourd’hui (Weather View v2):
- Afficher des cartes de données météo (pluie, température, humidité, vent) avec des résolutions spatiales et temporelles assez fines. Pour nos données de pluie, chaque pixel représente une zone d’environ 500m de côté, avec une résolution temporelle d’une minute.
- Proposer une interface fluide où la réactivité est maximale (navigation temporelle en déplaçant un slider, changement d’échelle de couleur, changement de l’opacité du calque de données).
- Afficher la valeur d’un pixel (ou cellule) au survol de la souris, ou au clic sur mobile.
Quand les besoins dépassent le système
Weather View v0
La toute première version de l’application répondait aux besoins du moment :
- Permettre à nos utilisateurs d’accéder aux données de nos capteurs en quelques mois.
- Afficher uniquement des cartes de pluie.
Les données de pluie sont principalement composées de valeurs à 0 (absence de pluie), et les cartes de pluie étaient produites pour de petites zones. Une solution simple et rapide a été de conserver uniquement les valeurs et les indices des pixels (ou cellules) contenant de la pluie, dans une colonne JSONB de PostgreSQL.
Afin d’offrir une expérience utilisateur optimale, nous avons choisi de charger 24h de données pour une date sélectionnée, soit 1440 minutes. Ainsi, l’utilisateur ne subissait pas un nouveau chargement des données lorsqu’on se déplaçait dans le temps sur une journée. La v2 fonctionne toujours sur ce principe.


Weather View v1
Une fois la v0 en production, une phase de R&D plus longue a donné naissance à un système de tuiles entièrement sur mesure, conçu pour passer à l’échelle: afficher de plus grandes zones, et gérer également des cartes de température et d’humidité.

Avantages de ce système:
- Les données sont découpées en tuiles, en suivant le standard défini par Google Maps: l’index de la tuile en haut à gauche de la carte est
{x: 0, y: 0}. - Chaque tuile a une résolution de 128x128 pixels, adaptée à la résolution de nos données.
- Le rendu des tuiles repose sur une grille cartésienne 512×512 fournie par deck.gl, au-dessus d’une basemap Mapbox. La grille cartésienne simplifie les calculs par rapport aux coordonnées web mercator (en mètres) ou géographiques (en degrés).
- Le rendu des tuiles dans le navigateur se fait dans un calque deck.gl
SolidPolygonLayer. Les valeurs de pluie sont à la fois représentées par l’échelle de couleur et la hauteur d’extrusion du polygone, ce qui améliore la lisibilité des données. - Le stockage est simple: les tuiles sont stockées dans un object storage, par produit, par date, et par type de tuile. Cette hiérarchie permet de générer facilement le chemin des tuiles à récupérer. Exemples:
/rain/2026-01-23/dcmt,/humidity/2026-01-23/dvmt. - Avec les bonnes optimisations, l’affichage des tuiles 4bits et 8bits est très fluide, même sur des appareils peu puissants.
Limites et contraintes:
- Système (trop) complexe:
- Le système d’encodage/décodage des tuiles reposait sur une seule personne, avec très peu de documentation.
- L’encodeur est écrit en C, un langage que personne d’autre dans l’équipe dev ne maîtrise. Il génère des fichiers binaires sur 4, 8 ou 16 bits, selon les contraintes liées aux données.
- Le décodage se fait en JS côté navigateur, mais est lui aussi très complexe, car les algorithmes “maison” de décodage/décompression changent complètement pour chaque type de tuile (4, 8, 16 bits). Cette complexité tient aussi à une lourde utilisation d’opérations bit à bit (bitwise operations).
- Le nombre de valeurs stockées dans une tuile est limité par son type:
- 4 bits → 16 valeurs
- 8 bits → 256 valeurs
- 16 bits → 65 536 valeurs, mais les tuiles sont alors de plus en plus lourdes. Elles sont utilisées uniquement pour stocker des valeurs précises de cumul (24h/jour ou 12 mois/an), mais elles ne sont pas adaptées au stockage de 1440 minutes (24h) d’intensité de pluie.
- Perte de précision:
- Avec seulement 256 valeurs, les tuiles 8 bits imposent de travailler avec des classes au lieu de travailler avec des valeurs précises.
- Ce manque de précision n’a qu’un faible impact sur les données de nos stations, dont la plage de valeurs est plus restreinte. Mais cela pose problème pour les données de modèles, comme AROME de Météo France, qui nécessitent à la fois une plage de valeurs plus large et une précision plus fine.
- La complexité du système pèse lourdement sur la productivité:
- Chaque modification ou ajout de paramètre prend du temps car il faut à chaque fois définir les concessions à faire: nombre de valeurs à enregistrer, gestion de l’imprécision, définition des échelles avec un nombre de valeurs limité, etc.
- Le code est difficile à appréhender, ce qui rend les modifications risquées, épuisantes, et génératrices de bugs.
- Une fois les tuiles encodées, vérifier l’intégrité des données ou retrouver la source d’un bug est toujours un défi.
Améliorer le système tout en le simplifiant
L’intégration des données du modèle AROME a fini de révéler les limites du système: le besoin de stocker une plage de valeurs plus étendue avec une grande précision le rendaient structurellement inadapté à ce type de données.
Conjugué au départ de la seule personne qui maîtrisait le système, ce qui a accentué l’effet “boîte noire”, ce constat a rendu la refonte nécessaire. C’était aussi l’occasion de repenser l’ensemble pour se libérer d’un maximum de contraintes.
Besoins identifiés:
- Amélioration de la DX (Developer Experience): rendre le système d’encodage/décodage plus simple à comprendre et à maintenir, en unifiant les 3 formats de tuiles en un seul.
- Amélioration de la productivité: pouvoir ajouter une nouvelle source de données en quelques semaines plutôt qu’en quelques mois.
- Lever les limites inhérentes au type de tuile: ne plus plafonner le nombre de valeurs enregistrables ni leur précision, en conservant une décimale (précision suffisante pour l’affichag dans Weather View).
- Génération rapide des tuiles: la génération de l’ensemble des tuiles pour un paramètre doit se faire en moins de 5mn, car nos cartes sont générées toutes les 5mn environ.
- Affichage de la carte rapide et fluide: tuiles légères pour un téléchargement rapide, décodage performant, et mise à jour de la carte sans lag lors du déplacement du slider temporel.
- S’appuyer sur des briques open source: utiliser des formats et librairies éprouvés par la communauté, avec des algorithmes d’encodage et de compression performants.
- Contenu vérifiable: pouvoir inspecter simplement une tuile, pour faciliter les tests et le debug.
- Timeseries d’un pixel: depuis la v0, nous souhaitions offrir la possibilité d’afficher le graphique d’une timeseries d’un pixel lorsqu’on clique dessus.
- Infrastructure simple mais efficace: avec une petite équipe de quelque personnes pour gérer à la fois le développement de nos produits et l’infra, il n’était pas envisageable d’ajouter trop de complexité à notre système.
J’ai commencé par explorer rapidement un éventail de solutions (liste non exhaustive) en essayant d’exploiter leur structure existante pour répondre à nos besoins:
- du côté géospatial: COG (Cloud Optimized GeoTIFF), Zarr, différents formats vectoriels (MVT tiles, GeoParquet, GeoArrow), data cubes (PostGIS-raster, TileDB, rasdaman).
- du côté des formats de sérialisation: Protocol Buffers, Avro, FlatBuffers.
Mais aucune solution existante ne permettait de répondre à l’ensemble de nos besoins. Plusieurs solutions étaient prometteuses, mais toutes présentaient des limites importantes: grande complexité, performances insuffisantes, structure inadaptée aux timeseries, support navigateur insuffisant.
En réutilisant les concepts qui fonctionnaient bien sur la v1, j’ai mis au point une nouvelle solution que nous appelons maintenant les TSTiles (TimeSeries Tiles), basées sur les formats Parquet/Arrow pour bénéficier des nombreux avantages apportés par ces formats de données en colonne.
Parquet apporte des optimisations avancées côté compression et encodage, une lecture partielle par row group, et c’est un format stable et répandu. Pendant mes tests, j’ai été impressionné par la capacité de ce format à stocker des millions de valeurs dans un fichier de quelques ko, lorsque les valeurs sont répétées ou très proches. Je reviendrai plus en détail sur ce point un peu plus loin.
Arrow permet des vitesses de lecture très rapides sur de grandes colonnes, grâce à un format de stockage en mémoire optimisé.
Un socle commun pour toutes nos données
La refonte du système de tuiles s’inscrivait dans une remise à plat plus large du stockage de toutes nos données.
Les fichiers produits pendant la génération des tuiles v1 n’étaient exploitables que par Weather View. Il n’était pas possible de les réutiliser pour d’autres usages, notamment les travaux de l’équipe data. Chaque besoin reposait sur son propre format, sans socle commun.
Il fallait un format unique, capable d’accueillir l’ensemble de nos données:
- Les données produites à partir de nos capteurs.
- Les données open data (Météo France, CHIRPS, etc.).
Objectif: un format stocké dans un object storage, sur lequel les équipes software et data peuvent travailler indifféremment, et que nous pouvons facilement partager avec nos partenaires et nos clients.
Après avoir comparé différents formats, le format NetCDF m’a semblé le plus approprié:
- Il est conçu pour stocker des données scientifiques multidimensionnelles.
- Il s’appuie sur des conventions standardisées par la communauté scientifique, notamment les conventions CF (Climate and Forecast), pensées à l’origine pour les modèles climatiques et météorologiques, puis étendues à l’ensemble des géosciences et aux données d’observation.
- Correctement renseigné, c’est un format auto-descriptif: ses attributs (unités, valeurs manquantes, description des variables, etc.) suffisent à comprendre les données, sans documentation externe.
- On peut définir un type adapté à la donnée, en prenant en compte qu’une grande précision impactera le poids du fichier, mais plusieurs optimisations permettent de réduire ce poids: différents algos et niveaux de compression, chunks, scale factor + offset, etc.
- Il bénéficie d’un large écosystème: des librairies disponibles dans de nombreux langages, et des outils de visualisation et d’analyse comme Panoply (NASA), QGIS, ou cdo (outil CLI).
Le format NetCDF est ainsi devenu le format de stockage de toutes nos données, et le point de départ des nouvelles tuiles.
Du NetCDF aux tuiles TSTiles
Un pipeline de transformation des fichiers NetCDF en tuiles TSTiles a été mis en place, dont voici les principales étapes.
Reprojection des données
Toutes nos données sont uniformisées en coordonnées géographiques WGS84 (EPSG:4326) au moment de la création des NetCDF. Avant de les découper en tuiles, les données sont d’abord re-projetées en Web Mercator (EPSG:3857), la projection la plus utilisée en cartographie sur le web.
Génération des fichiers Parquet
Lorsque les données des tuiles sont prêtes pour tous les niveaux de zoom, nous utilisons pyarrow pour générer les fichiers Parquet. Le zoom max dépend de la résolution des données.
De nombreux tests ont été effectués avec les données les plus contraignantes :
- des tuiles générées à partir de nos donnée de pluie, soit 1440 pas de temps (résolution temporelle: 1mn) sur 24h, avec beaucoup de valeurs à 0
- des tuiles générées à partir de nos données de température, soit 288 pas de temps (résolution temporelle: 5mn) sur 24h
Les mesures ont été faites sur un échantillon contenant des tuiles de tailles différentes.
La tuile dvmt8 est la tuile dvmt 8bits du système legacy, utilisée pendant mes benchmarks à titre indicatif, bien que la comparaison ne soit pas représentative compte tenu des pertes de précision et des contraintes techniques importantes.
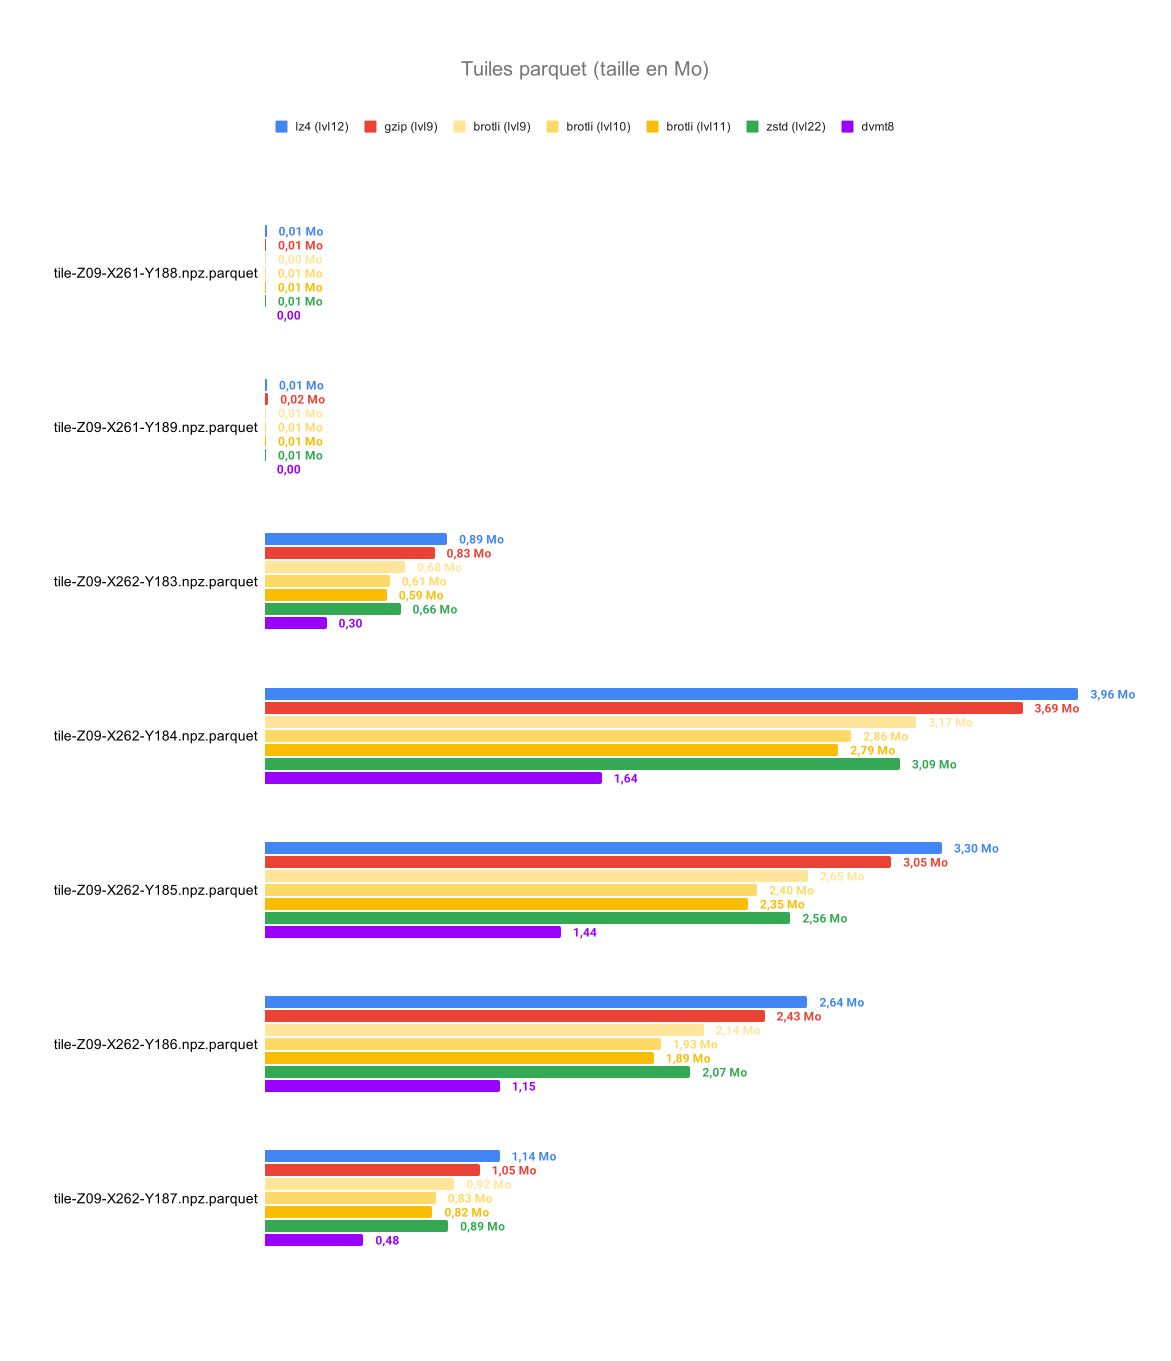
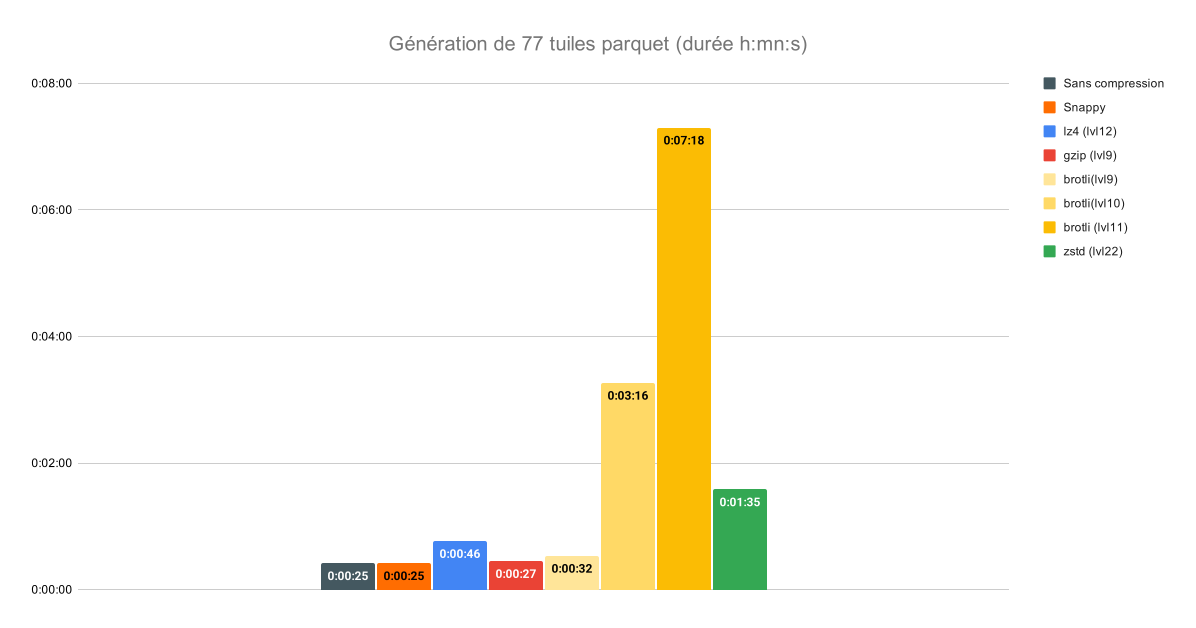
Le meilleur rapport entre la taille des fichiers Parquet et la vitesse de création de ces fichiers, a été obtenu avec cette configuration:
-
Matrices stockées à plat dans une colonne Arrow de type
int32et unscale_factorx10, on peut stocker de grands nombres avec une précision à une décimale.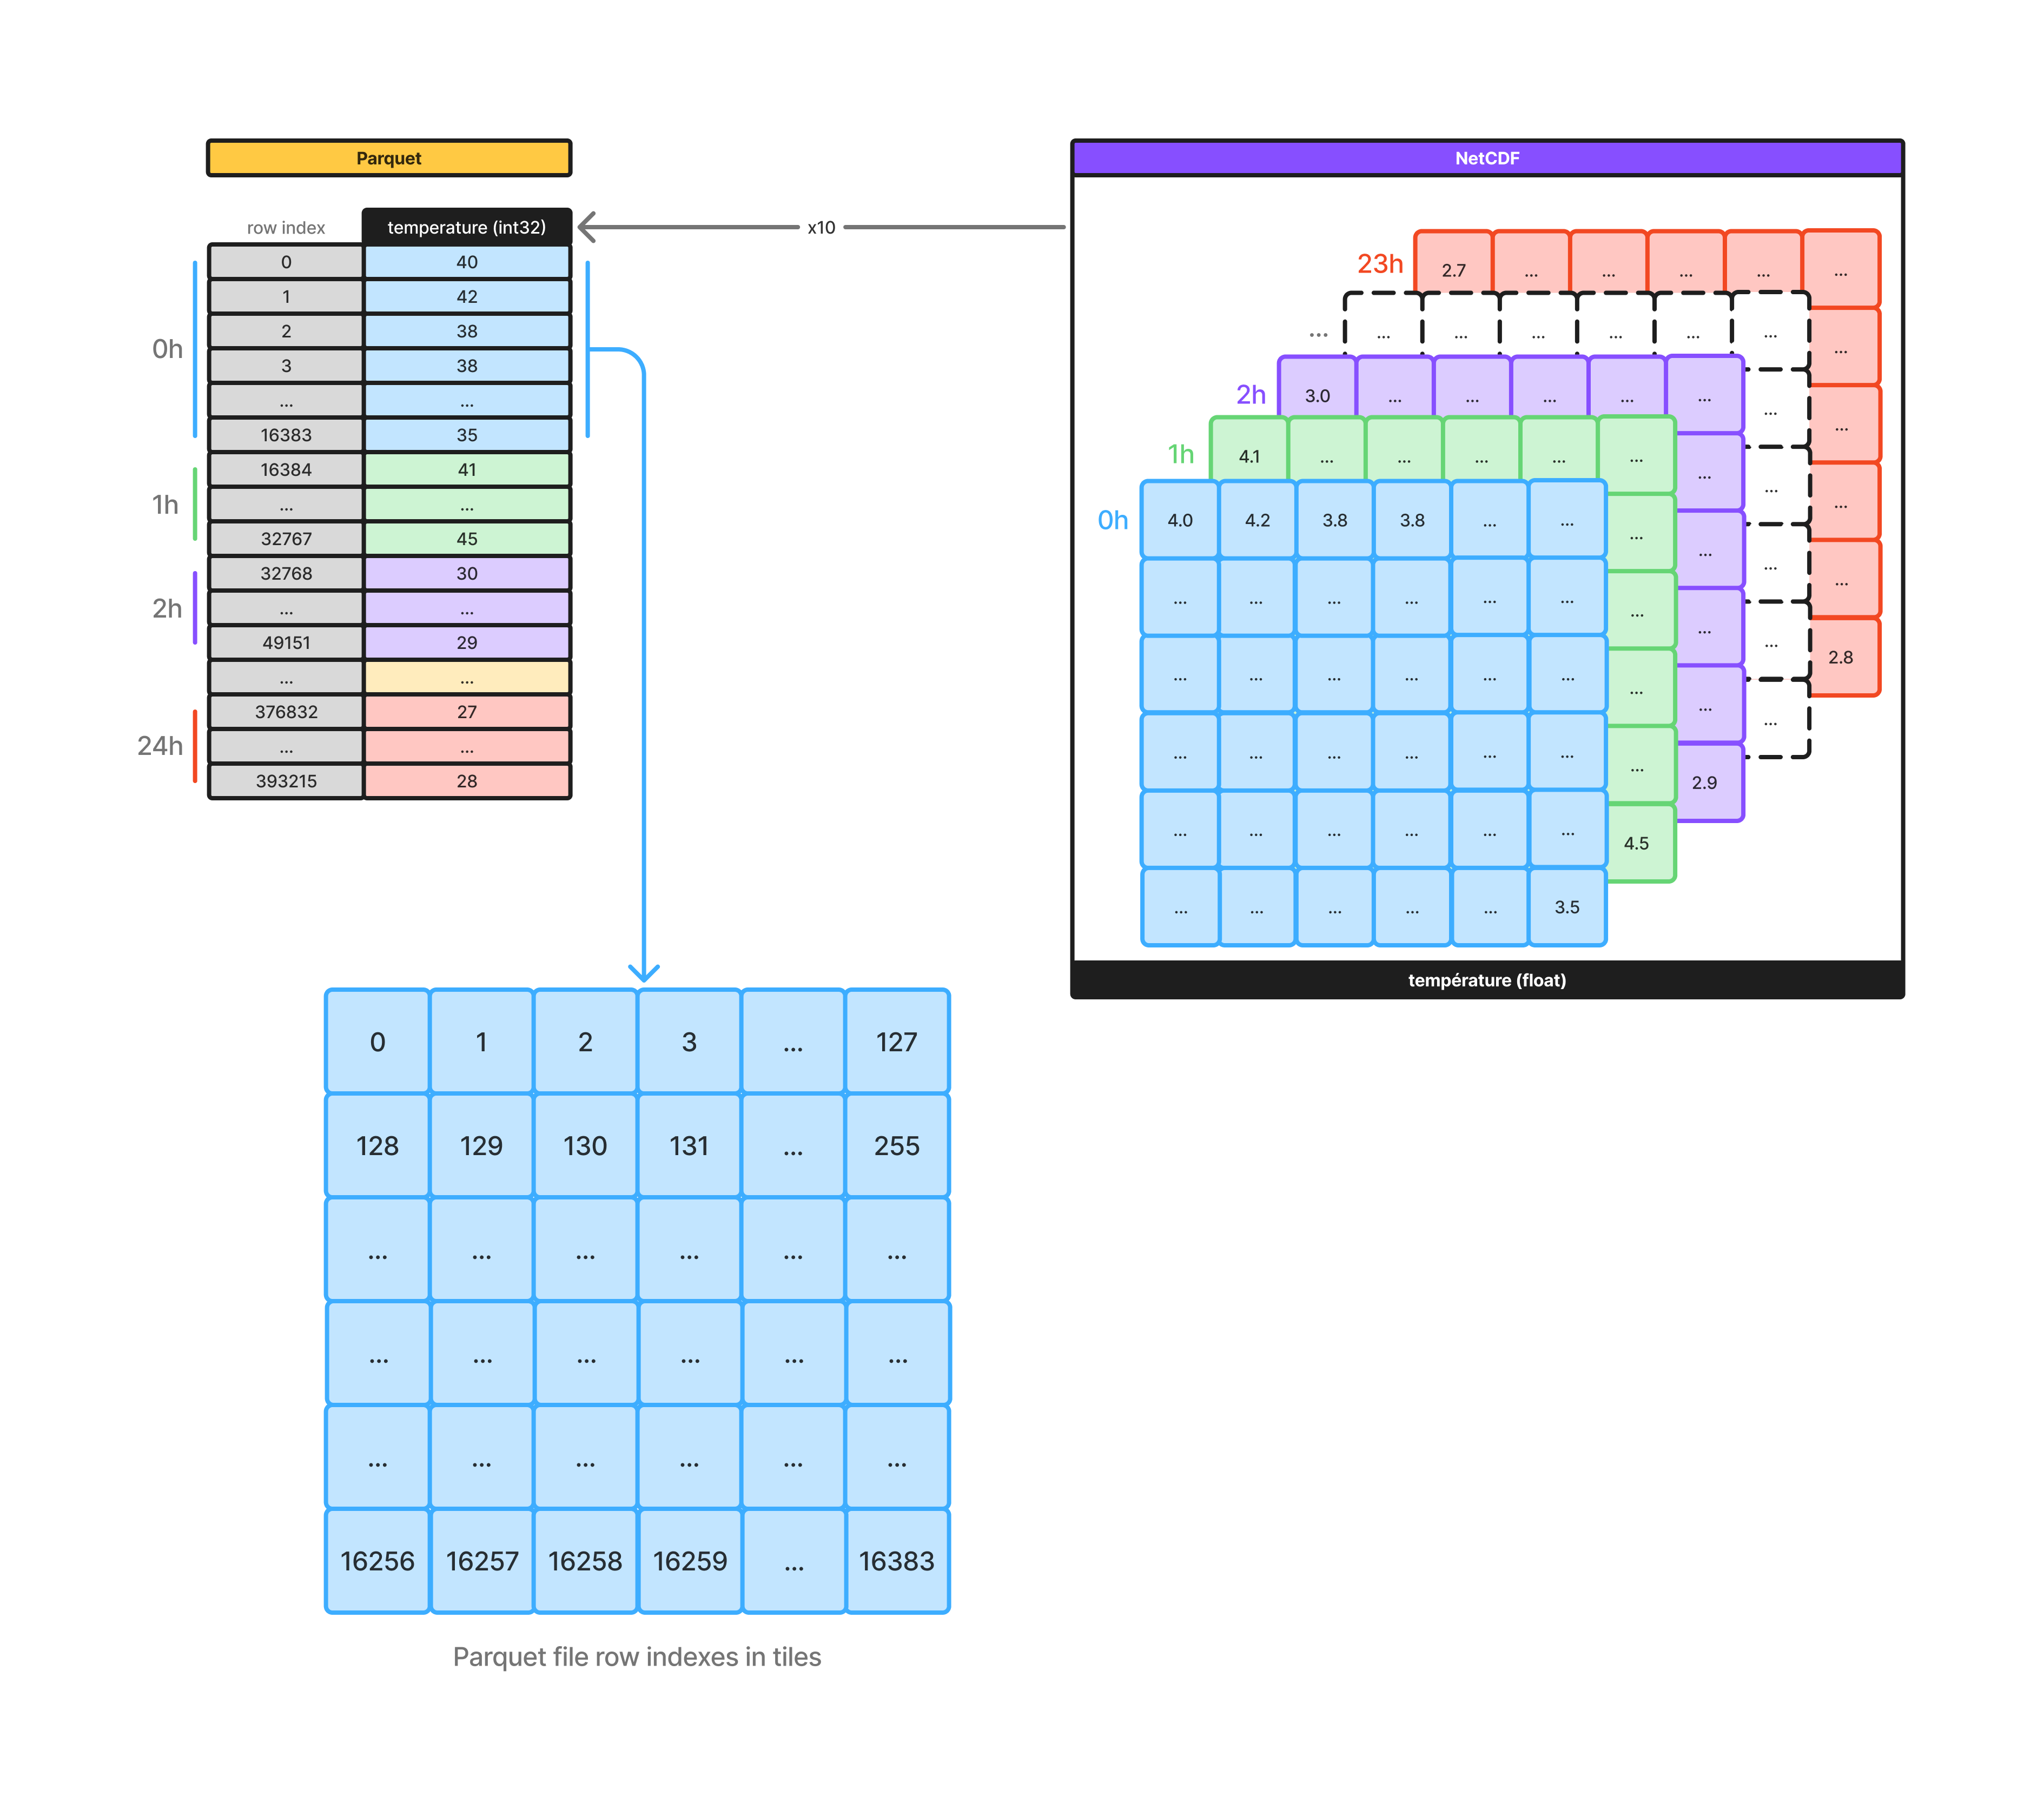
Données multidimensionnelles (NetCDF) converties en données à plat dans une colonne du fichier Parquet. -
Pour la création du fichier Parquet avec
pyarrow.parquet, nous utilisons ces paramètres.pq.write_table( arrow_table, # the data in a flat INT32 column output_file_path, use_dictionary=False, # this parameter must be disabled with DELTA_BINARY_PACKED encoding column_encoding="DELTA_BINARY_PACKED", compression="zstd", compression_level=22 )

Quelques précisions importantes:
-
Le passage à un stockage des données à plat peut sembler contre-intuitif pour des données multidimensionnelles, mais cela permet d’obtenir une excellente optimisation lors de la phase d’encodage/compression du fichier, et une lecture très rapide également. Cette structure des données augmente légèrement la complexité de la lecture, mais cela se fait au bénéfice de la vitesse de lecture et de la taille des fichiers.
La lecture d’un pas de temps (timestep) s’effectue en appliquant l’offset correspondant: pour des tuiles 128x128, l’offset sera donc
timestep_index x 128 x 128(outimestep_index x 16384). -
Avec
DELTA_BINARY_PACKED, on ne stocke pas les valeurs elles-mêmes mais les écarts entre valeurs consécutives, en utilisant seulement le nombre de bits strictement nécessaire. Sur le disque, chaque valeur peut n’occuper que quelques bits lorsque les écarts sont faibles. C’est souvent le cas des données météo que nous manipulons.De plus, nous quantifions au dixième via un scale factor ×10:
20,897est stocké209et affiché20.9. Cette légère réduction de précision, validée avec notre équipe scientifique, ne fait perdre aucune information significative à nos usages. À cette résolution, deux cellules spatialement voisines portent souvent la même valeur, les écarts sont ainsi nuls ou minimes.Résultat : nos tuiles basées sur les données du modèle AROME sont très légères: pour 24 pas de temps (1h) sur 24h, les plus grosses tuiles dépassent rarement 100ko pour la pluie et 300ko pour la température, mais la plupart sont bien plus légères.
-
Comme le montrent les graphiques, la compression brotli permettrait d’obtenir des fichiers à peine plus légers que zstd, mais au prix d’un temps de création du fichier presque 5x plus long, inadapté à nos besoins.
-
Un fichier Parquet peut également contenir des métadonnées:
-
Par défaut, on peut accéder aux métadonnées des colonnes.
{ "PathInSchema": ["rain"], "Type": "INT32", "Encodings": ["DELTA_BINARY_PACKED", "RLE"], "CompressedSize": 102075, "UncompressedSize": 192389, "NumValues": 393216, "NullCount": 0, "MaxValue": 138, "MinValue": 0, "CompressionCodec": "ZSTD" } -
Nous ajoutons également des métadonnées spécifiques à la tuile, nécessaires pour décoder les données, ou pour permettre la compréhension du contenu du fichier.
💡 Il est possible de lire uniquement les métadonnées sans télécharger les données.
{
  "tile_index": "Z07-X065-Y045",
  "x_size": 128,
  "y_size": 128,
  "parameter": "rain",
  "unit": "mm/h",
  "scale_factor": 0.1,
  "number_of_timesteps": 24,
  "date_utc": "2026-02-19",
  "datasource": "Arome 0.01 Météo France - Sereno",
  "version": "1.0.0"
}
-
Stockage des fichiers
Le stockage des tuiles se fait toujours dans un object storage. Le chemin reflète le produit et la date, mais la hiérarchie est plus simple que dans la v1 car il n’y a plus de type de tuile à gérer (dcmt, dvmt, dqmt).
Le backend vérifie que la requête est autorisée, puis il vérifie la présence de la tuile dans l’object storage, et l’envoie au front si elle est disponible.
Mise à jour des fichiers
Les tuiles doivent être mises à jour tout au long de la journée, pour mettre à jour et ajouter des données, mais un fichier Parquet ne peut pas être modifié directement.
La solution la plus simple est d’ouvrir le fichier Parquet existant avec pyarrow, modifier la table Arrow qui en résulte, puis écraser l’ancien fichier Parquet dans l’object storage avec la nouvelle version.
Affichage dans Weather View
Weather view v2 - déplacement du slider temporel pour explorer les données d’humidité sur 24h, sans rechargement des tuiles
Calques deck.gl
Le calque TileLayer de deck.gl est utilisé pour détecter les tuiles dans la zone visible de la carte.
Un calque custom TSTileLayer, basé sur le CompositeLayer de deck.gl, gère ensuite l’affichage des données sur la carte.
Détailler tout le fonctionnement du calque TSTileLayer serait très long, voici donc un schéma simplifié du cycle de vie du calque.

Les principales étapes:
- Event : les tuiles détectées sont injectées dans ce calque, ainsi que d’autres paramètres : échelle de couleur, opacité du calque, date, l’instant sélectionné sur le slider (minute, heure, mois), paramètres de viewport (zoom, rotation, inclinaison, etc.)
- Update : si une des propriétés passées au calque change, pendant cette étape le calque est mis à jour:
- Récuperation des données (worker):
- Au premier affichage du calque, les tuiles sont téléchargées, décodées avec parquet-wasm puis les références vers les données Arrow sont stockées dans
ArrowTableStore. - Puis, en fonction des propriétés modifiées, le cache de tuiles Arrow est lu directement, ou les tuiles manquantes sont téléchargées, décodées et stockées dans
ArrowTableStore. - Dès que les données Arrow sont disponibles, les valeurs du pas de temps sélectionné sont lues et renvoyées au main thread pour être stockées dans
TileDataStore.
- Au premier affichage du calque, les tuiles sont téléchargées, décodées avec parquet-wasm puis les références vers les données Arrow sont stockées dans
- Génération des polygones à partir des données de
TileDataStore(main thread):- les coordonnées des polygones sur la grille 512x512 sont calculées d’après l’indice de la tuile
- la valeur est utilisée pour définir la couleur du polygone ainsi que sa hauteur d’extrusion
- les coordonnées et attributs des polygones sont générés et affichés dans un
SolidPolygonLayer
- Récuperation des données (worker):
La mise à jour des données se fait ensuite en fonction du paramètre modifié:
-
Changement d’échelle de couleur ?
→ régénération des polygones à partir de
TileDataStore -
Un nouveau pas de temps a été sélectionné sur le slider ?
→ récupération des valeurs depuis
ArrowTableStore→ stockage des valeurs du pas de temps sélectionné dans
TileDataStore→ génération des polygones
-
Changement de date ?
→ invalidation de tous les caches
→ téléchargement des nouvelles tuiles dans le worker
→ lecture dans
ArrowTableStore→ stockage des valeurs du pas de temps sélectionné dans
TileDataStore→ génération des polygones
-
De nouvelles tuiles sont apparues dans le viewport quand l’utilisateur a manipulé la carte ?
→ téléchargement des tuiles manquantes dans le worker
→ lecture dans
ArrowTableStore→ stockage des valeurs du pas de temps sélectionné dans
TileDataStore→ génération des polygones
Décodage des fichiers Parquet
Il existe plusieurs librairies permettant de lire des fichiers Parquet dans le navigateur. La librairie parquet-wasm, créée par Kyle Barron, a donné les meilleures performances. L’API est claire et bien documentée.
Le décodage produit des données Arrow en mémoire WebAssembly. Pour les exposer à la mémoire JS, deux possibilité existent: IPC (Inter-Process Communication), qui impose une copie supplémentaire, et FFI (Foreign Function Interface), en zéro-copie.
Bien que présentée comme expérimentale dans la doc de parquet-wasm, nous utilisons la méthode FFI en production depuis plus d’un an sans aucun problème. Après avoir essayé les deux, le transfert via FFI nous était apparu sensiblement plus rapide qu’en IPC.
Optimisation des performances de rendu
Expliquer en détail chaque optimisation mise en place serait long, et cet article l’est suffisamment.
Voici simplement quelques éléments clés:
-
web worker: toutes les opérations permettant de télécharger/décoder des fichiers Parquet sont exécutées dans un web worker afin de paralléliser ce travail et de libérer le main thread. Ainsi, l’interface reste fluide pendant que ces tâches sont exécutées en parallèle.
Plus de travail aurait pu être délégué au worker, au prix d’une complexité accrue, mais j’ai préféré conserver un code plus simple et plus facile à maintenir tant que les performances étaient satisfaisantes.
-
2 “caches”:
- Une fois les fichiers Parquet décodés en tables Arrow, les références vers les tables Arrow sont stockées au niveau du web worker dans un
Map():ArrowTableStore. Chaque table Arrow contient les données à plat de tous les pas de temps d’une tuile. - Les données Arrow correspondant au pas de temps sélectionné sur le slider sont envoyées au main thread et stockées dans une propriété du calque
TSTileLayer:TileDataStore. Cette propriété est utilisée pour générer les polygones de la tuile. Tant que le pas de temps sélectionné ou la date sont identiques, ces données ne changent pas. Elles sont réutilisées pour ré-générer les polygones si des attributs comme l’échelle de couleur ou l’opacité du calque changent.
- Une fois les fichiers Parquet décodés en tables Arrow, les références vers les tables Arrow sont stockées au niveau du web worker dans un
-
pré-génération de l’échelle de couleurs: En pré-générant les échelles de couleurs pour toutes les valeurs possibles dans un
Map(), il suffit d’assigner une couleur indexée au lieu d’exécuter une fonction (nous utilisons chroma.js) pour définir la couleur de chacun des 16384 polygones de chaque tuile ! Et comme les valeurs de la tuile sont des entiers avant l’application duscale_factor, nous pouvons travailler avec des entiers ici, ce qui évite une complexité supplémentaire. L’impact en mémoire est négligeable, alors que le gain de performances est considérable. -
debounce + throttle : il a également été nécessaire de mettre en place debouncing et throttling à plusieurs endroits pour obtenir la fluidité souhaitée.
-
optimisation du format des données pour le GPU: en suivant les recommandations de la doc de deck.gl, une fois les polygones générés, les coordonnées et attributs sont convertis en tableaux typés, dans le format attendu par le GPU. Ce n’était pas le concept le plus simple à appréhender au début, mais avec un peu de concentration (et quelques tubes d’aspirine 🤯), le gain de performances était important sur les appareils dont la puissance est limitée, que ce soit en manipulant directement l’interface, ou en analysant plus précisément les performances dans les DevTools. Sur un MacBookPro M4 Pro, la différence est moins évidente.
Affichage de la timeseries d’un pixel
Dès que les tables Arrow sont stockées dans ArrowTableStore, il est possible d’accéder à la timeseries d’un pixel instantanément en cliquant dessus. Un graphique représentant la timeseries de ce pixel apparaît.
💡 Aucune requête au backend n’est nécessaire, mais seules les valeurs stockées dans la tuile sont disponibles.

Il suffit d’ajouter l’offset évoqué précédemment à l’index du pixel cliqué.
Par exemple, avec une de nos tuiles AROME (résolution temporelle = 1h), voilà comment récupérer les valeurs de la timeseries pour le pixel d’index 2 sur 24h:
const pixelIndex = 2;

const timestep0 = tileData[pixelIndex + 0 * 128 * 128];
const timestep1 = tileData[pixelIndex + 1 * 128 * 128];
const timestep2 = tileData[pixelIndex + 2 * 128 * 128];
// ...
const timestep23 = tileData[pixelIndex + 23 * 128 * 128];
Objectifs atteints
✅ Open source: en se basant sur des outils open-source éprouvés par la communauté (Parquet, Arrow, pyarrow, parquet-wasm), nous travaillons plus efficacement et nous pouvons concentrer nos efforts sur la valeur ajoutée de notre application.
✅ Expérience développeur (DX): le code est plus facile à comprendre, à maintenir, et à modifier. Il n’y a plus d’effet “boîte noire”, toute l’équipe peut prendre en main la chaîne de production. Et en cas de problème, il est bien plus facile de trouver sa source.
✅ Contenu vérifiable: il est facile de vérifier le contenu des tuiles, cela permet de contrôler la validité des données pour limiter les risques d’erreurs.
✅ Productivité: nous en avons fait l’expérience à plusieurs reprises, il est maintenant possible d’ajouter un nouveau paramètre météo en quelques semaines au lieu de plusieurs mois en moyenne avec le système précédent.
✅ Supprimer les limites de plages de valeurs et de précision: le type int32 permet d’enregistrer des valeur entre -2_147_483_648 et 2_147_483_647, pour les données météo que nous stockons dans ces fichiers. On peut désormais enregistrer des valeurs précises avec une décimale, ce qui est suffisant pour nos usages.
✅ Génération rapide des tuiles: actuellement seules les tuiles du modèle AROME sont générées dans ce format.
✅ Interface et carte réactives et fluides: pour la grande quantité de données affichées, les performances sont satisfaisantes, même si des optimisations de rendu restent à explorer.
✅ Timeseries instantanée d’un pixel: comme vu dans la section précédente, c’est maintenant possible.
✅ Infrastructure simple: le système de génération des tuiles est assez simple (en dehors des calculs de projection et d’interpolation, merci à l’équipe scientifique pour ce travail), et la tuile est stockée dans un object storage. Le serveur a besoin de peu de ressources pour récupérer les tuiles et les renvoyer au front.
Bénéfices inattendus
Initialement pensées et optimisées pour un affichage dans Weather View, les fichiers Parquet ont également permis de développer de nouveaux produits data.
En utilisant DuckDB pour lire les fichiers Parquet stockés dans un object storage, il a été possible de lire efficacement de très nombreux fichiers Parquet afin de générer des timeseries sur plusieurs années pour un emplacement sur la carte.
Un de nos produits générait ainsi une timeseries de 30 ans en 10-20 secondes (la recherche dépendait de plusieurs paramètres), pour une adresse sélectionnée par l’utilisateur.
Conclusion
Les TSTiles tournent en production depuis plus d’un an. Les bénéfices évoqués dans l’article ainsi que l’expérience DuckDB illustre bien ce que l’on gagne à s’appuyer sur des standards ouverts. Il reste encore plusieurs pistes à explorer, qui pourraient permettre à la fois d’améliorer les performances et de simplifier le système.
Mon aventure de 5 ans chez Sereno est terminée, mais je prévois de continuer à travailler autour de ce sujet passionnant en open source. Si ces recherches conduisent à des résultats intéressants, ce sera un bon sujet pour un futur article.